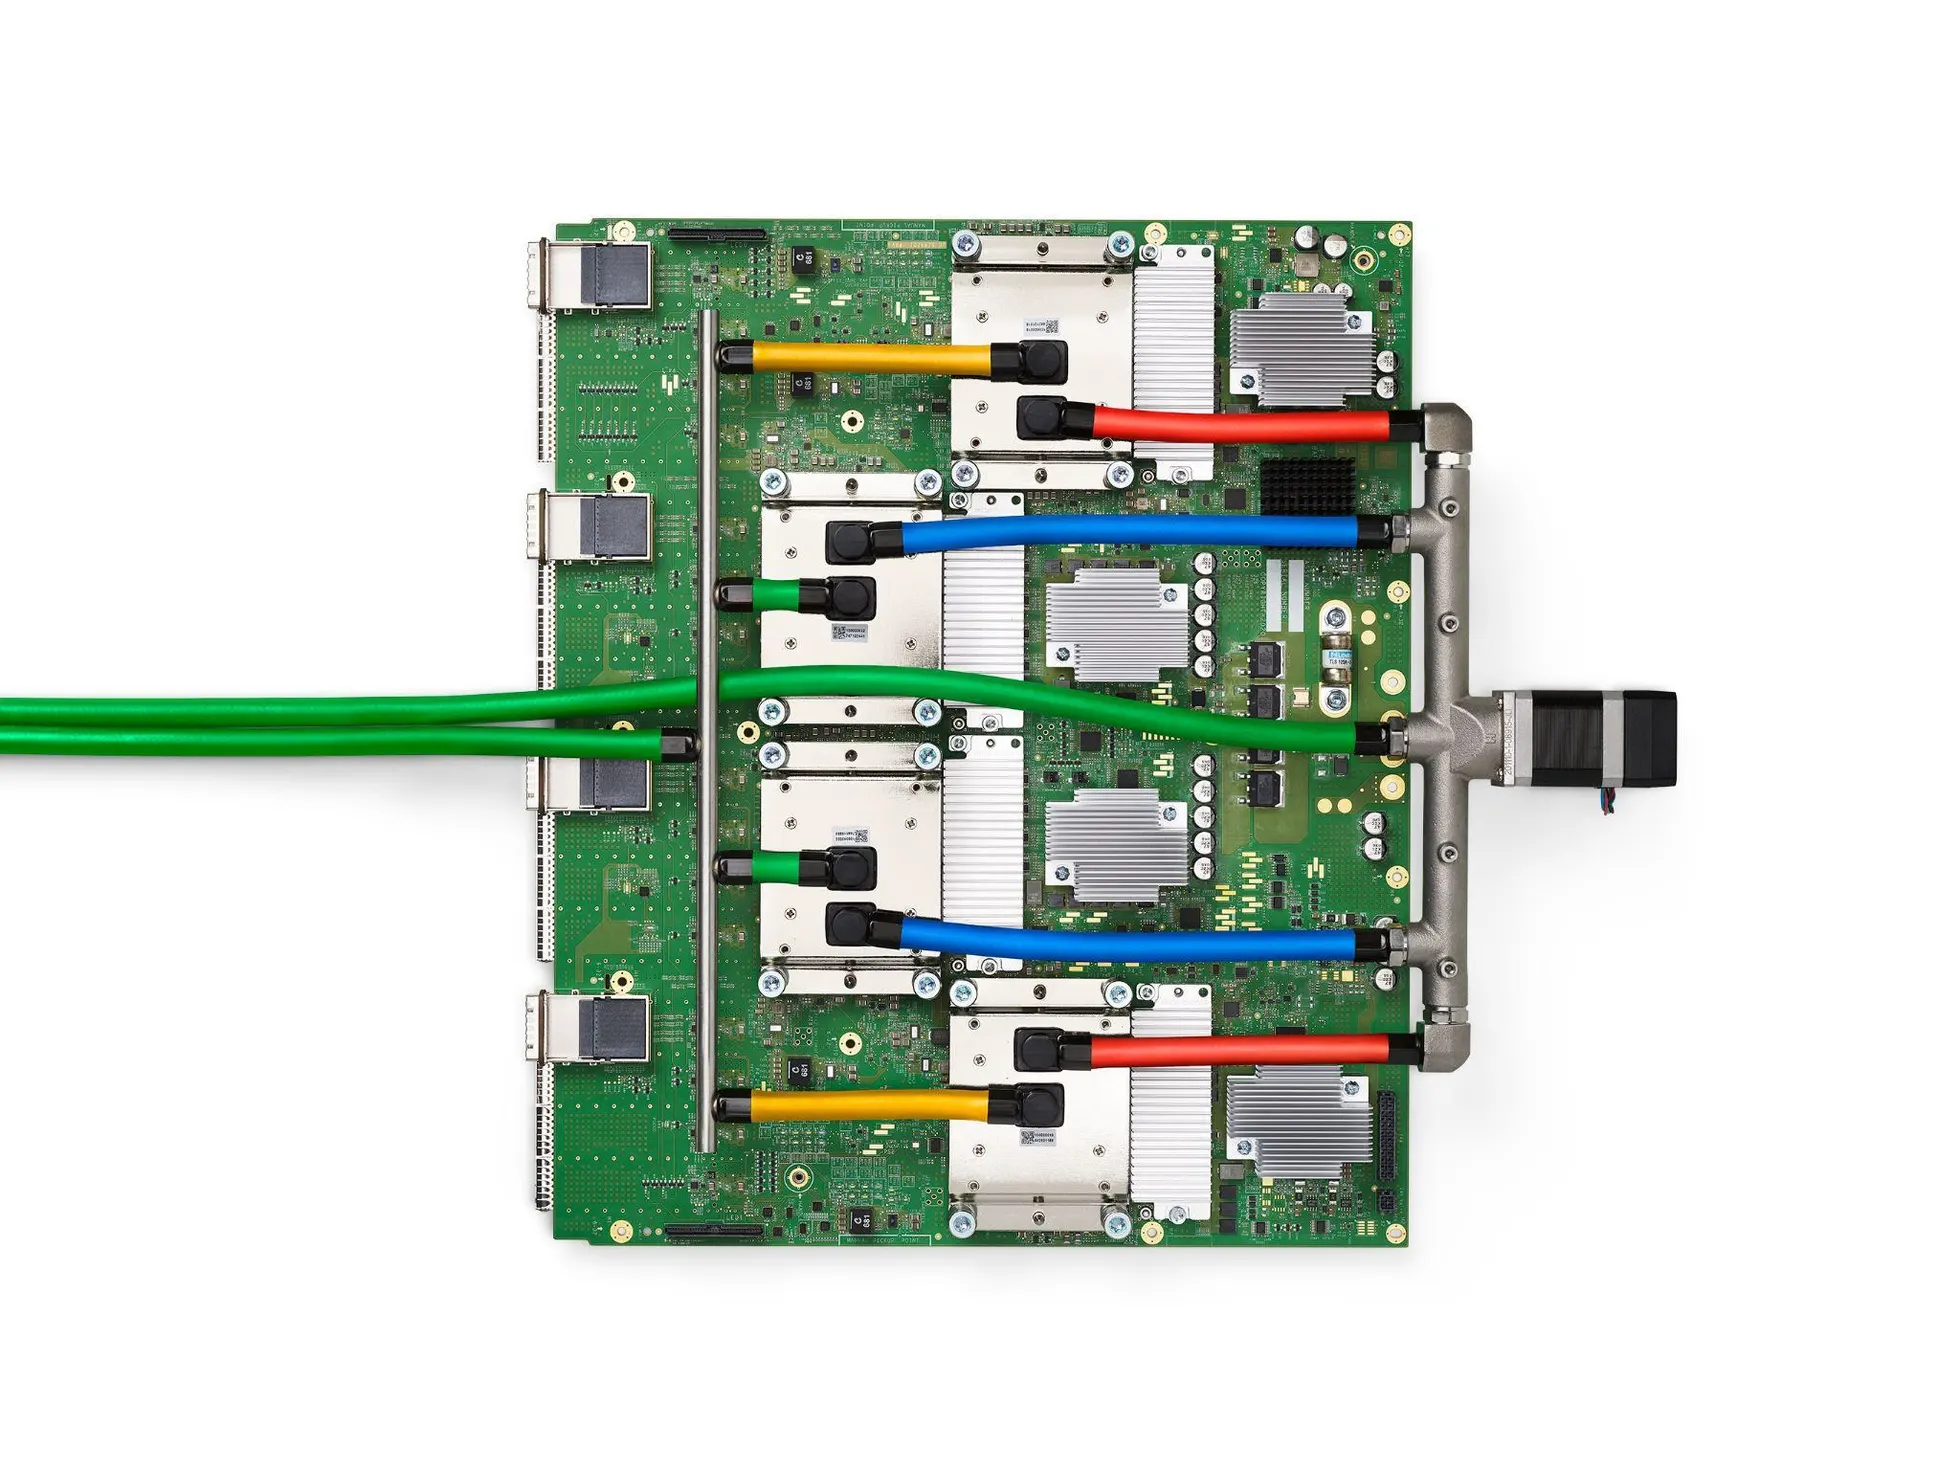
O Google abriu o código do TorchTPU, sua stack nativa de PyTorch para os chips TPU. O anúncio saiu em 20 de outubro, durante a PyTorch Conference 2026, e coloca os TPUs no mesmo patamar de GPUs e CPUs dentro do framework mais usado para treinar e servir modelos de IA. O repositório já está público no GitHub, na organização google-pytorch.
Até aqui, rodar PyTorch em TPU exigia camadas de adaptação que quebravam com frequência e afastavam equipes acostumadas ao ecossistema CUDA da Nvidia. O TorchTPU ataca justamente esse ponto: foi desenvolvido em parceria com o time de PyTorch da Meta e roda cargas de trabalho existentes com mudanças mínimas de código. Dá para depurar em modo eager, como em qualquer projeto PyTorch, e depois passar para o torch.compile quando a fase é produção, com ganho de desempenho e menor uso de memória.
Um ecossistema inteiro chegou junto
O anúncio não foi só da stack base. O Google listou integrações prontas com quase todo o arsenal open source de IA:
- Hugging Face: a partir do Transformers v5, basta passar
device_map="tpu"para rodar modelos abertos do Hub em TPU. A biblioteca Diffusers também roda nativa, com suporte a eager, torch.compile e paralelismo de tensores para modelos generativos grandes. - vLLM: desenvolvido com a Inferact, o backend nativo traz batching contínuo, quantização e paralelismo multi-chip para servir modelos em produção.
- SGLang: em parceria com a RadixArk, acelera cargas agênticas e estruturadas, reaproveitando cache de KV entre requisições.
- llm-d 1.0: lançado com Red Hat, IBM e uma comunidade de mais de 500 contribuidores de 25 organizações, o projeto entra no sandbox da CNCF e faz o roteamento de requisições entre réplicas em frotas de TPUs e GPUs no Kubernetes.
- Treinamento: o TorchTitan, implementação de referência do PyTorch para treino distribuído, foi validado em até 8.192 TPUs Ironwood, com até 52% de aproveitamento de FLOPs no Qwen 3 8B.
- VeRL e Ray: o framework de aprendizado por reforço ganhou backend de TPU integrado ao projeto oficial, e o Ray passa a orquestrar pipelines mistos de CPU, GPU e TPU na mesma rotina.
Há ainda duas peças menores: o LiteRT, runtime de inferência em dispositivos, entrou para o ecossistema PyTorch com conversão em uma linha (litert-torch.convert()), e um conjunto de agentes para onboarding e diagnóstico em TPU, o TPU agent suite, está em preview no GitHub.
Por que isso mexe no tabuleiro
A disputa real aqui não é de benchmark, é de padrão. Durante anos, escolher PyTorch na prática significava escolher GPU Nvidia, porque era onde o software funcionava sem atrito. Com o TorchTPU upstream no próprio ecossistema PyTorch, o TPU deixa de ser um caminho exótico e vira opção de catálogo: mesmo código, mesmas ferramentas, outro fornecedor de computação.
Para o Google, é a peça que faltava para vender TPU para quem já tem código em produção. Para a Meta, Hugging Face, vLLM e companhia, é a garantia de que o ecossistema aberto não fica refém de um único chip. E para o mercado, mais concorrência de hardware tende a pressionar o custo por token, que hoje é o gargalo de qualquer operação de inferência em escala.
O que isso significa no Brasil
Para desenvolvedores e empresas brasileiras, o efeito prático é um só: workload de PyTorch que hoje roda em GPU na nuvem pode ser testado em TPU sem reescrever o projeto, o que abre espaço para comparar custo real de treino e inferência entre os dois caminhos. A ressalva importante é que TPU não se compra em loja: o acesso continua sendo via Google Cloud, em dólar, então a conta precisa considerar latência, região de dados e preço por hora de cada acelerador. Para times que estão decidindo onde gastar com IA, a lógica de começar barato e escalar só quando precisa continua valendo, como mostra o nosso guia sobre quando o modelo menor resolve e quando vale subir para o Pro.