Google lançou o Gemini 4 Argon em outubro de 2026, disponibilizando o modelo no aplicativo Gemini e no modo de IA na Busca para assinantes dos planos Google AI Pro e Ultra anúncio oficial. O lançamento ocorreu duas semanas após a ampliação do acesso ao modelo para desenvolvedores e empresas por meio da API paga, AI Studio e plataforma Gemini disponibilidade API. Para usuários brasileiros, a novidade traz um modelo de raciocínio avançado que promete respostas mais diretas, menos repetição e ganhos de produtividade em tarefas como programação, finanças e cybersegurança, mas só está acessível mediante assinatura paga.
Segundo o anúncio oficial, o Argon responde perguntas de forma mais direta, com menos hedging e evita repetição desnecessária anúncio oficial. Ele também compartilha seu progresso com mais frequência em tarefas longas, mantendo o usuário informado anúncio oficial. No ambiente de desenvolvimento, o modelo permite alternar entre conversa e codificação diretamente no app Gemini para macOS, graças à integração da interface Antigravity anúncio oficial. Esses recursos visam reduzir a fricção em fluxos de trabalho que exigem alternância constante entre pensamento e execução.
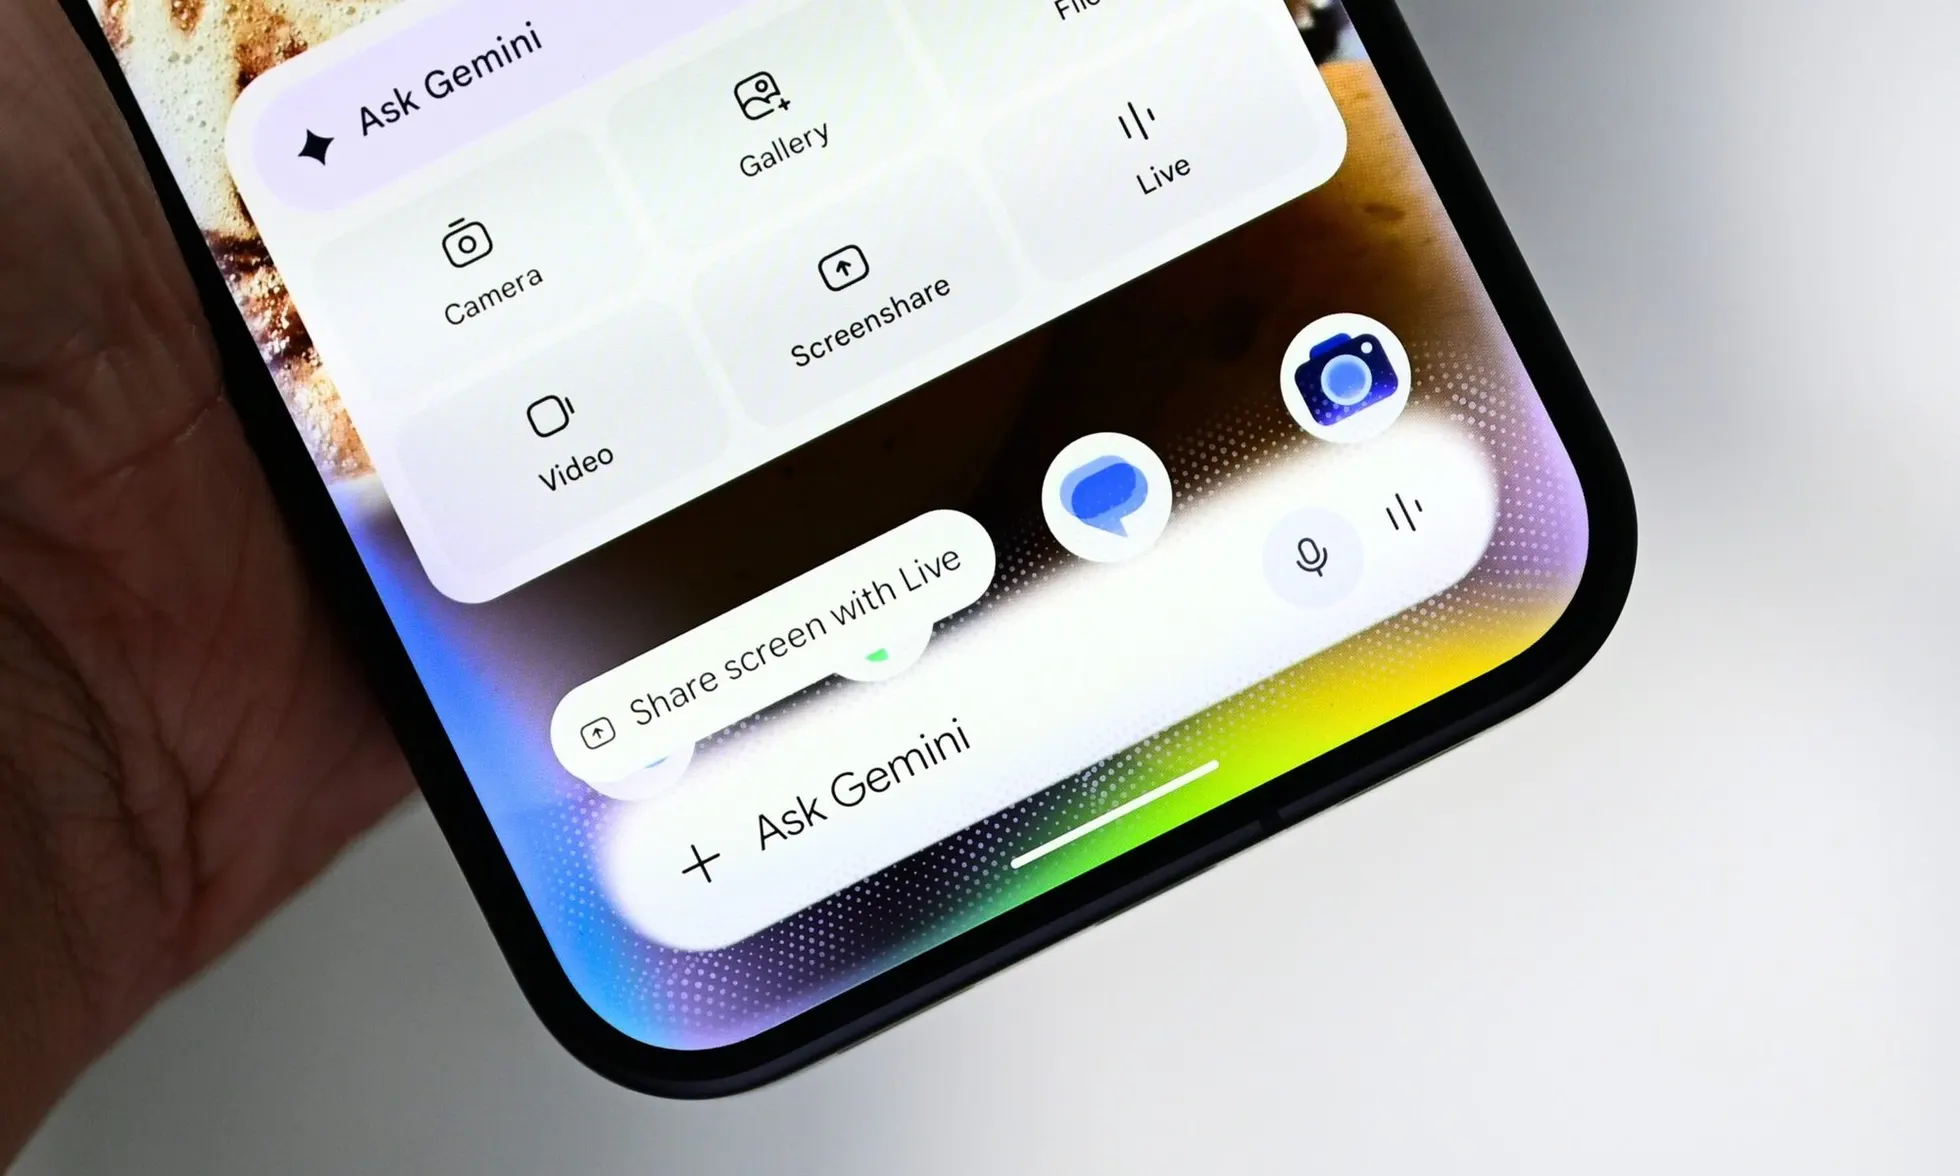
Google / Divulgação. Imagem mostra o aplicativo Gemini com o novo modelo Gemini 4 Argon disponível para assinantes
OVERRATED ↑
achar que o Gemini 4 Argon elimina a necessidade de revisão humana em código
UNDERRATED ↓
o aumento de mais de 35% nos submits de código agente com redução de rollbacks quase um terço no Antigravity
Como o Gemini 4 Argon melhora raciocínio e código
Segundo o anúncio oficial, o Argon responde perguntas de forma mais direta, com menos hedging e evita repetição desnecessária anúncio oficial. Ele também compartilha seu progresso com mais frequência em tarefas longas, mantendo o usuário informado anúncio oficial. Em programação, o modelo trouxe melhorias significativas, permitindo que equipes do Google aumentassem os submits de código agente em mais de 35% enquanto reduziam os rollbacks quase um terço ao usar a interface Antigravity detalhes de desempenho. Esses ganhos mostram que o Argon pode acelerar refatoração de grandes bases de código e otimização de fluxos de trabalho sem exigir reescrita manual.
Além disso, o modelo possui um limite de 1 milhão de tokens de saída para raciocínio profundo, um salto frente aos 64 k tokens das versões anteriores limite de tokens. Essa capacidade permite que o Argon mantenha o contexto em fluxos de trabalho extensos, como a análise de documentos jurídicos extensos ou a simulação de cenários financeiros complexos.
Desempenho em benchmarks e casos de uso no mundo real
Nos testes internos do Google, o Argon ajudou a melhorar a otimização de algoritmos quânticos em 40% em questão de minutos otimização quântica. Na área de eficiência de memória, agentes Argon identificaram e aplicaram otimizações que liberaram mais de 300 TiB de memória nos data centers da empresa, com potencial para chegar a 1 PiB eficiência de memória. Em migrações de grande escala de código, o modelo auxiliou na transição de C/C++ para Rust em bibliotecas como re2, libgav1 e até 800 k+ linhas do kernel Zircon do Fuchsia, produzindo decodificadores de vídeo que rodam 2,7× mais rápido que o equivalente Rust migração de código.
Em benchmarks específicos, o Argon lidera o Vals Index, que mede desempenho em finanças, código, legal e tributo, ficando em primeiro lugar Vals Index. No teste DeepSWE v1.1, que avalia engenharia de software de longo horizonte, o modelo alcançou 77,9 % de acurácia DeepSWE. Para compreensão de vídeo longo, o Argon atingiu 91,7 % no LVBench, sendo o estado da arte LVBench. Em tarefas de geração de código agente, equipes do Google observaram aumento de mais de 35 % nos submets e redução de quase um terço nos rollbacks ao usar a interface Antigravity submits de código.
Casos de uso divulgados incluem a refatoração de centenas de arquivos no código do Chrome, onde o modelo separou o tratamento central de páginas da web de um legado de cerca de seis milhões de linhas, concluindo meses de trabalho em semanas refatoração Chrome. Também foi utilizado para otimizar o kit de desenvolvimento de agentes (ADK), reduzindo o tempo de preparação de sessão em 40 % e acelerando importações a frio em 21 % otimização ADK. No pacote de química quântica xTB, o Argon chegou a ser 2,3× mais rápido na previsão de estruturas moleculares e 1,8× mais rápido na busca de conformeres otimização xTB. Nos modelos Gemma 4, obteve aceleração de 2,85× na taxa de inferência em um A100 via vLLM, mantendo paridade de tokens aceleração Gemma. Em visualizações 3D, o modelo permitiu a criação de um templo pagode fotorealista em Blender, um jogo de corrida em miniatura a partir de uma mesa real e um motor de ray‑tracing puro em Python visualizações 3D.
Disponibilidade, preços e planos
O Gemini 4 Argon está acessível globalmente por meio da API paga do Gemini, do AI Studio e da plataforma Gemini para desenvolvedores e empresas disponibilidade API. Assinantes do Google AI Ultra também podem usá‑lo no ambiente Antigravity, enquanto os planos Pro e Ultra dão acesso dentro do app Gemini e da IA na Busca acesso nos apps. O preço introdutório é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com desconto de 95 % para tokens de entrada em cache preço introdutório. Esse valor vale até 30 de novembro de 2026, depois disso subirá para US$ 4 e US$ 20 respectivamente reajuste de preço. Usuários gratuitos do Gemini continuam sem acesso ao modelo.
Nos Estados Unidos, o plano Google AI Pro custa US$ 20 mensais e o Ultra parte de US$ 100 mensais preços dos planos. Para desenvolvedores que utilizam a API, o acesso ao Argon em Antigravity e AI Studio está restrito a assinantes do Ultra, enquanto no app Gemini e na Busca tanto Pro quanto Ultra têm permissão restrição Antigravity. A empresa havia planejado lançar um modelo 3.5 Pro, mas optou por liberar o Argon em seu lugar modelo 3.5 Pro.
O que isso significa no Brasil
Usando a cotação PTAX de R$ 5,0096 por dólar em 13/10/2026 e a regra da Remessa Conforme, o preço introdutório de US$ 2 por milhão de tokens de entrada equivale a aproximadamente R$ 10,02, e o de US$ 10 por milhão de tokens de saída a cerca de R$ 50,10. Após 30/11/2026, o preço dobrará para US$ 4 e US$ 20, ou seja, R$ 20,04 e R$ 100,19. Nos EUA, o plano Google AI Pro custa US$ 20 mensais e o Ultra parte de US$ 100 mensais. Convertendo pela mesma cotação, isso resulta em aproximadamente R$ 100,19 para o Pro e a partir de R$ 500,96 para o Ultra (estimativa). Esses números são estimativas baseadas na cotação PTAX e não representam preços oficiais divulgados pela Google para o Brasil.
Os usuários brasileiros devem observar eventuais anúncios de planos locais ou ajustes de valores antes de considerar o uso do modelo.
Fontes primárias verificadas (7) ▾
- blog.google — Gemini 4 Argon comes to the Gemini app.
- digitaltrends.com — Gemini 4 Argon is finally available for developers, businesses, and paid users
- blog.google — Gemini 4 Argon: Built to solve your hardest problems
- blog.google — Gemini 4 Argon: our next era of frontier intelligence
- engadget.com — Google's Gemini 4 Argon is now available in the Gemini app and AI Mode in Search - Engadget
- arstechnica.com — Gemini 4 Argon begins rolling out in Gemini app and Antigravity, but only if you pay
- bcb.gov.br — Contexto Brasil: PTAX (BCB) e Remessa Conforme